Scraping
Ne všechna data někdo nabízí v JSON, XML nebo CSV. Kurzy místní směnárny visí jen na jejím webu, napsaný v tabulce určené lidem. Kdo je chce mít každý den v tabulkovém procesoru, může je opisovat, nebo napsat program, který to udělá za něj.
Co je scraping
Scraping (z anglického scrape, škrábat) je automatické vytahování dat ze stránek určených lidem. Program, tzv. scraper, si stránku stáhne stejně jako prohlížeč, jen ji nikomu neukáže. Najde v ní elementy s daty, vytáhne z nich text a uloží ho třeba do CSV.
Používá se všude, kde je potřeba dát dohromady data z mnoha stránek:
- srovnávače cen procházejí e-shopy a sbírají ceny zboží,
- hlídací služby sledují nové inzeráty bytů nebo aut,
- výzkumníci a novináři sbírají data z veřejných rejstříků a zpravodajských webů,
- vyhledávače procházejí celý web a ukládají si obsah stránek.
Tag, třída a id
Stránka je HTML soubor a představuje strom elementů. Kurzy směnárny můžou ve zdrojovém kódu vypadat takhle:
<p>Aktualizováno v <time id="updated">8:00</time></p>
<table id="rates">
  <tr class="rate-row">
    <td class="currency-code">EUR</td>
    <td class="buy">23,80</td>
    <td class="sell">24,90</td>
  </tr>
  <tr class="rate-row">
    <td class="currency-code">USD</td>
    <td class="buy">21,25</td>
    <td class="sell">22,30</td>
  </tr>
</table>
Scraper potřebuje vědět, ve kterých elementech data leží. Element se dá poznat podle tří věcí: podle tagu, tedy druhu elementu (td je buňka tabulky), podle třídy v atributu class, kterou autor stránky dává prvkům stejného druhu a která se na stránce opakuje, a podle id, jedinečného jména, které se na stránce smí objevit jen jednou.
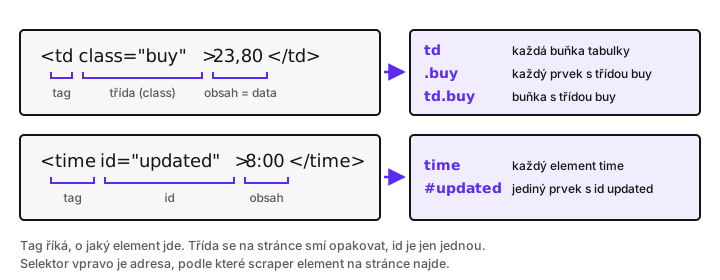
Adresa elementu se zapisuje jako selektor, stejně jako v CSS. Samotný název tagu vybere všechny elementy toho druhu, tečka znamená třídu a mřížka id. td tak vybere kódy i oba kurzy, .buy jen nákupní kurzy a #updated jediný údaj o aktualizaci.
Selektory se dají skládat. #rates .buy vybere prvky s třídou buy uvnitř elementu s id rates, tr.rate-row jen řádky tabulky s třídou rate-row. Hodí se to, když se stejná třída na stránce objeví i tam, kde ji nečekáme.
Na data se nejlépe hodí třída, protože popisuje význam: nákupní kurz má buy, ať je měn pět, nebo padesát. Id se hodí pro věc, která je na stránce jen jednou. Použít jako selektor jen název HTML značky většinou moc nefunguje.
Jak je stránka postavená, ukážou vývojářské nástroje prohlížeče:
- Klikněte pravým tlačítkem na údaj, který vás zajímá, a zvolte Prozkoumat (anglicky Inspect). Nástroje otevře i klávesa F12 nebo zkratka Ctrl+Shift+I na Windows a Linuxu, na Macu Cmd+Option+I. V Safari je musíte nejdřív zapnout v nastavení v části Pokročilé.
- Otevře se panel s HTML stránky, v Chrome a Edge se jmenuje Elements, ve Firefoxu Inspector. Element, na který jste klikli, je v něm zvýrazněný. Když po řádcích kódu jezdíte myší, prohlížeč na stránce ukazuje, který kus jim odpovídá.
- Šipkou v levém horním rohu nástrojů nebo zkratkou Ctrl+Shift+C, na Macu Cmd+Shift+C, přepnete do výběru: najedete myší na prvek na stránce a kliknete.
- U vybraného elementu přečtete tag, třídu i id. Trojúhelníčkem vlevo se rozbaluje, co je uvnitř.
Scraping, nebo API?
Když směnárna nabízí API, programy si o kurzy řeknou přímo a dostanou je jako JSON, jaký jsme viděli na začátku lekce. API je domluvené rozhraní pro programy, takové oficiální dveře k datům.
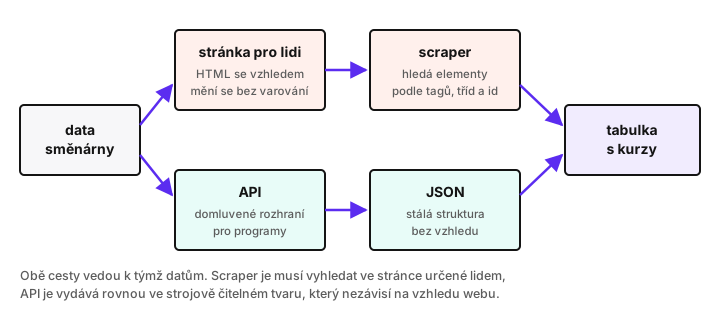
S API je to jednoduché: zeptáte se předepsaným způsobem a dostanete hezky zabalená a naformátovaná data. Pokaždé stejně.
Scraping je opisování cen z výlohy obchodu. Funguje, dokud majitel výlohu nepřerovná.
Struktura API se obvykle mění jen ohlášeně, kdežto stránka se může změnit kdykoli: stačí nový vzhled webu nebo přejmenovaná třída a scraper přestane fungovat. Scraper navíc stahuje celé stránky i s tím, co nepotřebuje, a když se ptá moc často, zatěžuje server víc než API.
V praxi se o scraper musíte neustále starat. Stačí, že e-shop v noci nasadí nový vzhled, a ráno je v tabulce dat načítaných z obchodu prázdno, i když doposu vše fungovalo. Firmy, které mají na scrapingu postavený business model, proto mají hlídání, které na takovou změnu ihned upozorní.
API má podmínky používání sepsané, u scrapingu si pravidla musíme zjistit sami:
- Soubor
robots.txtv kořeni webu říká, které části webu nemají automatické programy procházet. Není to zákon, ale slušný scraper ho dodržuje. - Podmínky užití webu automatické stahování často výslovně zakazují.
- Texty a fotky chrání autorské právo a celou sbírku dat může chránit i zvláštní právo pořizovatele databáze. Co je veřejně vidět, nesmíme automaticky hromadně kopírovat a znovu zveřejňovat.
- Osobní údaje chrání GDPR i tehdy, když jsou na webu veřejně.
Z toho plyne první krok před každým scrapingem: zjistit, jestli web nenabízí API nebo export dat ke stažení. Odkaz na ně bývá v patičce, pod názvy jako API, Pro vývojáře nebo Otevřená data. Jak se s API pracuje, si ukážeme v další lekci.
Otevřete si https://cs.wikipedia.org/robots.txt. Řádek User-agent říká, kterému robotovi pravidla platí, a Disallow cestu, kam nesmí. Najděte roboty, kterým Wikipedie zakazuje celý web, a u jednoho z nich zkuste dohledat, proč asi.