XML
Tentýž lístek jde zapsat i jinak. XML (Extensible Markup Language) je o pár let starší než JSON a data zapisuje jako pojmenované značky vnořené do sebe.
Elementy a atributy
<?xml version="1.0" encoding="UTF-8"?>
<exchange name="Směnárna U Mostu" date="2026-11-05">
  <open>true</open>
  <rate code="EUR">
    <buy>23.80</buy>
    <sell>24.90</sell>
  </rate>
  <rate code="USD">
    <buy>21.25</buy>
    <sell>22.30</sell>
  </rate>
  <rate code="GBP">
    <buy>28.40</buy>
    <sell>29.85</sell>
    <note>jen bankovky</note>
  </rate>
</exchange>
První řádek je tzv. prolog: říká, že jde o XML a v jakém kódování je soubor uložený. Pod ním začínají elementy. Element má otevírací značku <buy>, obsah a zavírací značku </buy>, která se liší lomítkem. Uvnitř elementu můžou být další elementy, a tak vzniká stejné zanoření jako v JSON.
Do otevírací značky se dají přidat atributy, dvojice název a hodnota: code="EUR". Hodnota atributu je vždy v uvozovkách. Element bez obsahu se smí zapsat zkráceně, <note/> je totéž co <note></note>.
Jestli vám zápis něco připomíná, je to správně. HTML, ze kterého jsou webové stránky, má stejné značky i atributy, jen jeho elementy (p, table, a) jsou předem dané. V XML si názvy elementů vymýšlíme sami podle toho, co data popisují.
Element, nebo atribut?
Kód měny jsme dali do atributu, kurz do elementu. Hrubé vodítko zní: atribut nese údaj o datech (identifikátor, jednotku, datum), element nese samotná data. Kód měny říká, o kterém kurzu je řeč, a kurz je to, co nás zajímá.
Přiznejme si ale, že je to hlavně věc zvyku. Stejně správně by šlo dát kód do vlastního elementu <code>EUR</code>, nebo naopak oba kurzy do atributů: <rate code="EUR" buy="23.80" sell="24.90"/>. Pevné je jen jedno: do atributu se nedá nic zanořit. Co se může časem rozrůst, patří do elementu.
Správně utvořený dokument
XML je stejně přísné jako JSON. Dokumentu, který dodržuje pravidla zápisu, se říká správně utvořený (well-formed), a jen takový program přečte:
- každý element musí mít otevírací a zavírací značky, nebo je zapsaný zkráceně jako samouzavírací značka, např.
<note/> - značky se nekříží: co se otevřelo později, musí se zavřít dřív
- dokument má právě jeden kořenový element, ve kterém leží všechno ostatní
- velikost písmen se rozlišuje,
<Rate>a</rate>nejsou to stejné a nepatří k sobě - znaky
<a&se v textu zapisují jako<a&, jinak je program považuje za začátek značky.
Chybně:
<rate code="EUR"><buy>23.80</rate></buy>
<rate code="USD"><buy>21.25</buy></rate>
Tady jsou chyby dvě: značky rate a buy se kříží a dokument má dva kořenové elementy. Prohlížeč takový soubor nezobrazí a místo stromu vypíše chybu s číslem řádku a sloupce, kde se zarazil. U HTML prohlížeč podobné chyby tiše opravuje, u XML ne.
Kde XML potkáme
- RSS, ve kterém zpravodajské weby a podcasty zveřejňují nové články a díly,
- SVG, obrázky složené z čar a tvarů, včetně ilustrací v tomhle kurzu,
- kancelářské dokumenty:
.docxa.xlsxjsou zip plný souborů XML, - elektronické faktury, v Česku ve formátu ISDOC,
- výměna dat mezi úřady a bankami; Česká národní banka zveřejňuje denní kurzovní lístek mimo jiné v XML.
RSS (Really Simple Syndication) je způsob, jak může web jednoduše sdílet svůj obsah pro další strojové zpracování. Načíst ho může třeba speciální čtečka, která pak uživateli na jednom místě nabízí články z mnoha různých webů. RSS používá jako formát dat XML.
Podívej se například na RSS feed serveru lupa.cz.
JSON, nebo XML?
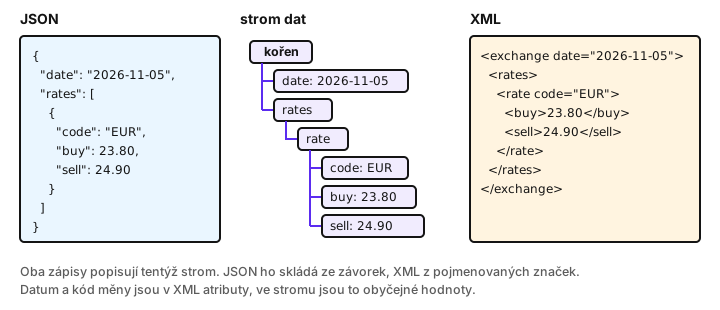
Oba formáty popisují tentýž strom: kořen, pod ním hodnoty a vnořené skupiny. Liší se tím, jak ho zapisují.
Na čitelnost je JSON kratší a na první pohled přehlednější. XML zase u každé hodnoty nese její jméno i na konci, takže se v dlouhém dokumentu hůř ztratíme.
Na velikost vychází hůř XML, protože každý název značky opakuje dvakrát. Jeden kurz zapsaný bez mezer:
{"code":"EUR","buy":23.80,"sell":24.90}
<rate><code>EUR</code><buy>23.80</buy><sell>24.90</sell></rate>
JSON má 39 znaků, XML 63, tedy zhruba o 60 % víc. U jednoho kurzu je to jedno, u milionu záznamů posílaných po síti už ne.
V datových typech má navrch JSON: rozliší číslo, text, logickou hodnotu i null. V XML je všechno text, a že 23.80 je číslo a true logická hodnota, musí vědět program, který dokument čte. Prázdnou hodnotu XML vyjádří tak, že element vynechá, jako poznámku u eura a dolaru výš.
Ve využití si formáty rozdělily území. JSON vládne webu a API, protože je úsporný a JavaScript ho přečte bez převodu. XML zůstává v dokumentech a ve formálnějších a starších systémech úřadů, bank a účetnictví. Tam se cení, že k dokumentu může existovat schéma (XSD), podle kterého program ověří, že dokument obsahuje předepsané elementy ve správném pořadí a se správnými hodnotami.
Udělejte si kopii libovolného dokumentu .docx a změňte jí příponu na .zip. Na Windows k tomu musíte v Průzkumníku v nabídce Zobrazit zapnout přípony názvů souborů, na Macu Finder změnu přípony nechá potvrdit a na Linuxu stačí soubor přejmenovat. Archiv otevřete a najděte v něm word/document.xml. Poznáte v něm text dokumentu? A kolik značek obklopuje jedno slovo napsané tučně?